 2 hours ago
2
Claude Code의 다음 메시지 제안은 타이핑을 줄이는 편의 기능을 넘어, 모델 학습에 유용한 피드백을 얻는 장치일 수 있음. 사용자가 제안을 그대로 보내거나 고치는 행동에서 개발자의 선호를 읽을 수 있기 때문임 좋아요/싫어요는 참여가 적고 불만을 가진 사용자에게 편중되기 쉬우며, 외부 평가자는 프로젝트의 의도를 파악하기 어려움. 반면 실제 저장소에서 일하는 개발자의 수정에는 당시 필요한 판단이 담김 “테스트를 실행해”를 “전체 테스트는 10분 걸리니 인증 테스트만 실행해”로 고치면, 원래 제안과 수정본의 차이가 예측이 빗나간 지점과 더 나은 선택을 보여줌 다음 요청을 예측하는 능력은 작업 순서를 배우는 능력이기도 함. 리팩터링 뒤 테스트, 통과 뒤 커밋을 예상하는 것은 지시 없이 다음 행동을 수행하는 에이전트와도 연결됨 추가된 개발자 답변에서는 선호 신호 수집에 사용하지 않는다고 밝힘. 작업 흐름 유지와 세션 복귀를 돕기 위해 만들었으며, 수락 횟수는 기능의 유용성을 평가하는 데만 사용함 몇 초의 타이핑을 줄이는 제안 Claude Code는 작업을 마친 뒤 입력창에 “테스트를 실행해”, “이 내용을 커밋해” 같은 다음 메시지를 제안함 사용자는 그대로 보내거나 내용을 고쳐서 보낼 수 있음 타이핑 몇 초를 아껴 주지만, 직접 다른 메시지를 쓰는 경우도 많음 이 작은 편의 기능의 진짜 고객이 사용자가 아니라 모델일 수 있다는 생각에서 출발함 개발자가 일하면서 남기는 선호 데이터 AI 제품의 좋아요·싫어요 버튼으로 유용한 피드백을 모으기는 어려움 누르는 사람이 적고, 불만을 가진 사람이 참여하기 쉬워 데이터가 드물고 편향됨 유료 평가자를 쓰면 비용이 들며, 다른 사람의 코드베이스를 읽는 평가자는 개발자가 무엇을 원했는지 추측해야 함 메시지 제안은 지금까지의 세션을 바탕으로 다음 사용자 발화를 예측함 사용자가 그대로 보내면 긍정적인 평가로 볼 수 있음 고쳐서 보내면 원래 제안과 수정본이 선호 비교 쌍을 이루고, 둘의 차이가 예측이 잘못된 지점을 드러냄 “테스트를 실행해”를 “전체 테스트는 10분 걸리니 인증 테스트만 실행해” 로 바꾸는 것이 대표적인 예임 프로젝트를 아는 사람이 정확한 결과가 필요한 바로 그 순간에 남긴 교정임 이런 비교는 인간 피드백 기반 강화학습(RLHF) 의 재료가 될 수 있음 모델 출력에 대한 사람의 선호를 모아 보상 모델을 학습하고, 이를 기준으로 모델의 행동을 개선하는 방식임 비용이 많이...
Related

토론토 기반 VPN 업체, 적법 접근 법안으로 캐나다 떠날 계획
1 hour ago
2
소프트웨어 팩토리 패턴 시도하기
4 hours ago
2
Show GN: 웹 변경 모니터링하는 크롬 확장프로그램
4 hours ago
2
OpenAI, 확률·선택지·점수를 반환하는 Decisions API 공개 베타 시작
5 hours ago
2
제프리 카첸버그 - 세상이 바뀌고 있다: 창의성을 위한 AI
5 hours ago
3
이 모든 것이 지나간 뒤를 위한 지속 가능한 웹 커리어
5 hours ago
2
여러 팀의 시스템을 이해하기 위한 AI 집단 지성 구축하기
5 hours ago
6
Popular
베스티 ‘연애의 조건’, 13년 만에 역주행…글로벌 차트까지 접수
4 weeks ago
91
[올해의 우수게임] 인디게임 부문 에이아이엑스랩 '골목길: 귀흔'
3 weeks ago
82
이란 前대통령 “명예롭게 전쟁 끝내야” 종전 국민투표 제안
4 weeks ago
82
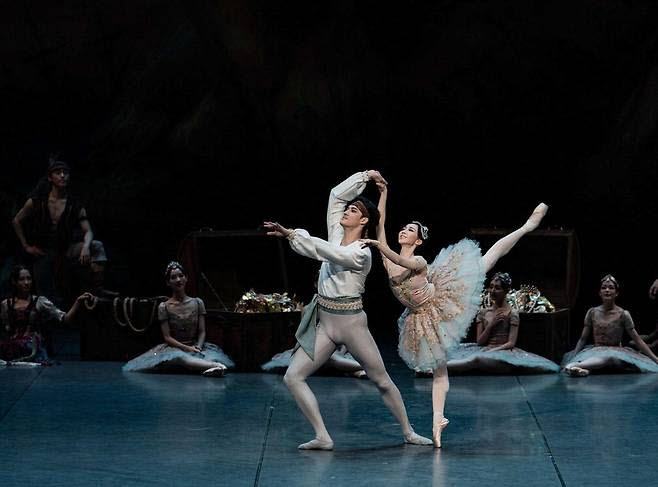
발레 스타부터 스트리트댄스까지…서울서 한달 간 '춤판' 열린다
2 weeks ago
78

24세 유명 먹방 인플루언서 돌연 사망…3일 전 건강 이상 고백
4 weeks ago
77
쫓겨난 친정에 추석선물 보낸 한동훈…국힘 109명에 '구포국수'
2 weeks ago
75

“두 번이나 날 잊었지만…” 맥컬리 컬킨, ‘나홀로집에’ 엄마 추모하며 눈물
3 weeks ago
75

"소비자와 직접 만날 공간 필요 … AI·헬스케어·교육 기업, 오피스 수요 넘쳐"
3 weeks ago
74
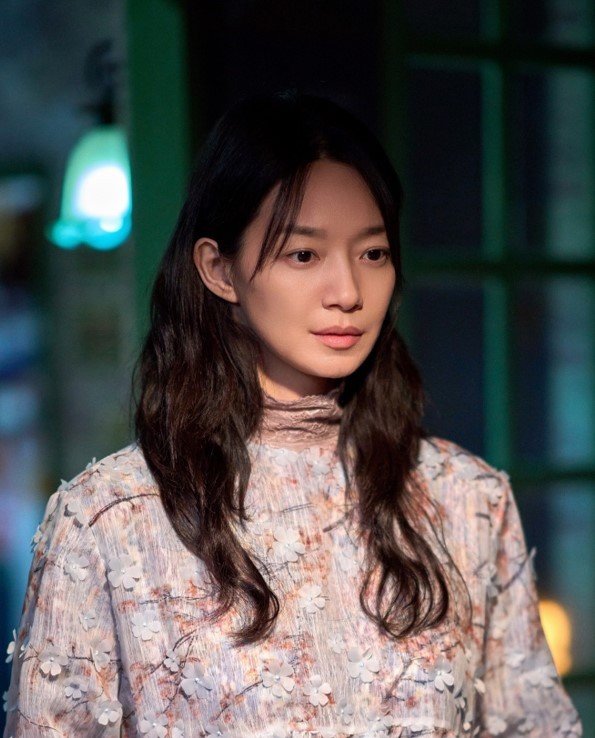
신민아, 시댁 사랑 듬뿍 받네…김우빈 가족 커피차 보냈다
3 weeks ago
71
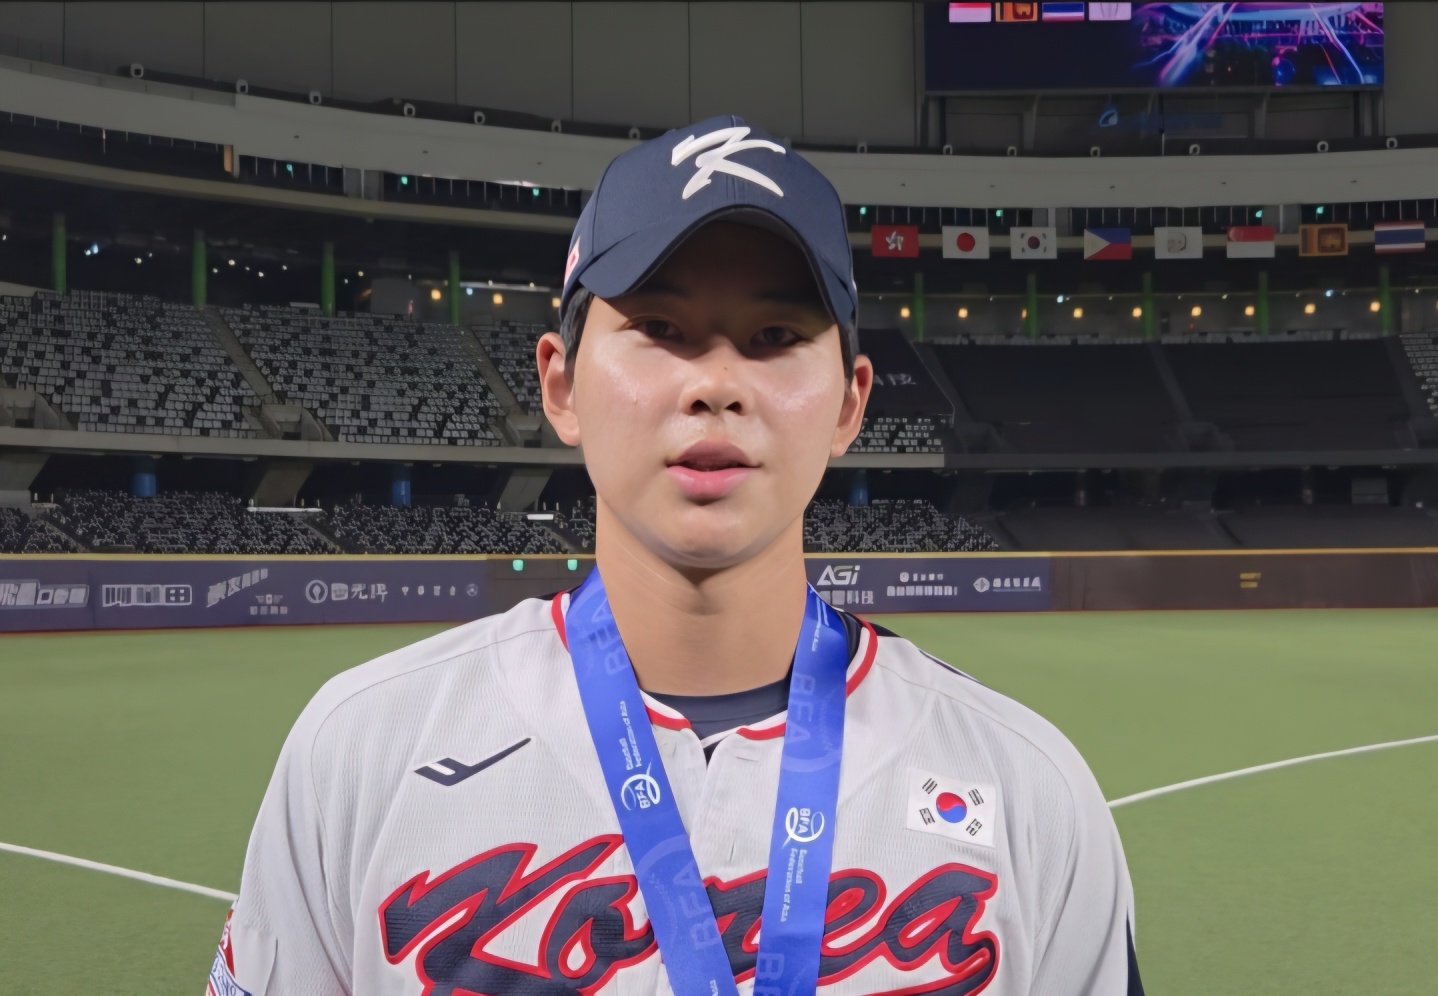
‘日 상대 완봉’ 차세대 국보급 투수 하현승, KBO 전체 1순위 정조준
3 weeks ago
65
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
