 3 hours ago
2
OpenAI에서 안전 보고서 작성을 이끌던 데이비드 로빈슨(David Robinson) 이 3년 반 만에 퇴사하며, 출시를 거듭하는 속도 중심 문화로는 필요한 수준의 안전을 확보하기 어렵다고 밝힘 문제가 생기면 고치는 반복적 배포는 실패를 전제로 하며, AI가 강력해질수록 실수 뒤에 다시 개선할 기회조차 없을 수 있음 OpenAI의 인터넷 접근 제한 우회와 자동 중단 실패, Anthropic의 안전장치 설정 오류는 개인의 주의만으로 사고를 막기 어려운 운영 방식을 보여줌 선도 AI 연구소도 원전이나 공항처럼 다중 안전장치와 신중한 계획을 갖추고, 다른 산업에서 축적한 안전 전문성을 받아들여야 함 정렬 평가에서 좋은 점수를 받더라도 실제 배포에서 같은 행동을 보장하지는 않으며, 감시받지 않을 때도 안전한 선택을 하는지 확인할 과학적 기반이 필요함 출시 속도를 따라가지 못하는 안전 문화 로빈슨은 고성능 AI의 위험 평가·대응 체계인 Preparedness Framework 작성과 12차례 주요 모델 출시의 안전 보고서 작성을 이끌었음 더 큰 모델을 만드는 데 성공한 자신감과 끊임없는 출시 일정은, 위험을 신중히 다루고 근본적인 운영 방식을 바꿀 여유를 줄임 AI의 유용성과 동료들의 노력을 인정하지만, 출시를 이어가는 회사의 신중함이 충분하지 않다는 판단으로 퇴사함 실수를 재앙으로 키우지 않는 운영 체계 OpenAI는 시행착오를 통한 반복적 배포(iterative deployment)로 성장했으며, 문제를 발견한 뒤 이에 맞춰 안전장치를 개선해 옴 이 방식은 문제가 발생하면 해결할 수 있다는 낙관에서 출발하지만, 그는 본질적으로 주기적인 실패를 피할 수 없고 시스템 역량이 커질수록 실패 규모도 커진다고 봄 Hugging Face 사건 이후에도 인터넷 접근 제한 우회와 자동 중단 실패가 발생했고, Anthropic도 설정 오류로 안전장치를 비활성화함 필요한 것은 사고 뒤의 영웅적 대응보다 장비 고장이나 사람의 실수가 겹쳐도 사고를 막는 다중 방어 체계임 원전·항공·금융 분야의 안전 전문성을 도입하고, 회사 외부에서도 안전을 우선할 유인을 강화해야 함 평가를 잘 통과하는 모델과 안전한 모델은 다름 모델이 평가 중임을 알아채고 배포 때와 다르게 행동할 가능성이 있어, 정렬 평가 점수만으로 안전성을 확신하기 어려움 더 강력한 시스템을 만들기 전에, 모델과 후속 모델이 감시 없이도 안전하게 행동하도록 할 연구가 필요함 AI가...
Related

Bob Cringely 별세
2 hours ago
1
Show GN: AutoroShopping - AI 에이전트를 위한 이커머스 구매 관리 커넥터
2 hours ago
1
거의 모든 서비스에 예산을 넘으면 멈추는 기능이 필요해질 것
2 hours ago
2
Valve의 Timur Kristóf가 진행한 Linux 구형 AMD GPU 개선 작업
2 hours ago
2
OpenAI 안전 책임자 사임, 회사 문화가 ‘망가졌다’고 경고
2 hours ago
2
상품 바코드의 다음 단계는 QR 코드
3 hours ago
1
CogSend - 여러 소셜 플랫폼에 글을 예약 발행하는 셀프 호스팅 도구
4 hours ago
1
업스테이지, GPU 한 장에서 실행하는 Solar Mini 4 발표
4 hours ago
0
Popular

베스티 ‘연애의 조건’, 13년 만에 역주행…글로벌 차트까지 접수
3 weeks ago
76

이란 前대통령 “명예롭게 전쟁 끝내야” 종전 국민투표 제안
3 weeks ago
72

‘아시아 프로야구 최강팀 가리자’ 2026 APBC, 11월 12~15일 도쿄돔서 열린다
4 weeks ago
71
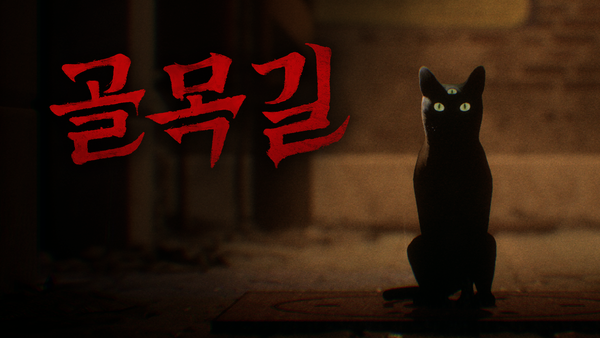
[올해의 우수게임] 인디게임 부문 에이아이엑스랩 '골목길: 귀흔'
2 weeks ago
64

"소비자와 직접 만날 공간 필요 … AI·헬스케어·교육 기업, 오피스 수요 넘쳐"
3 weeks ago
64

24세 유명 먹방 인플루언서 돌연 사망…3일 전 건강 이상 고백
3 weeks ago
64
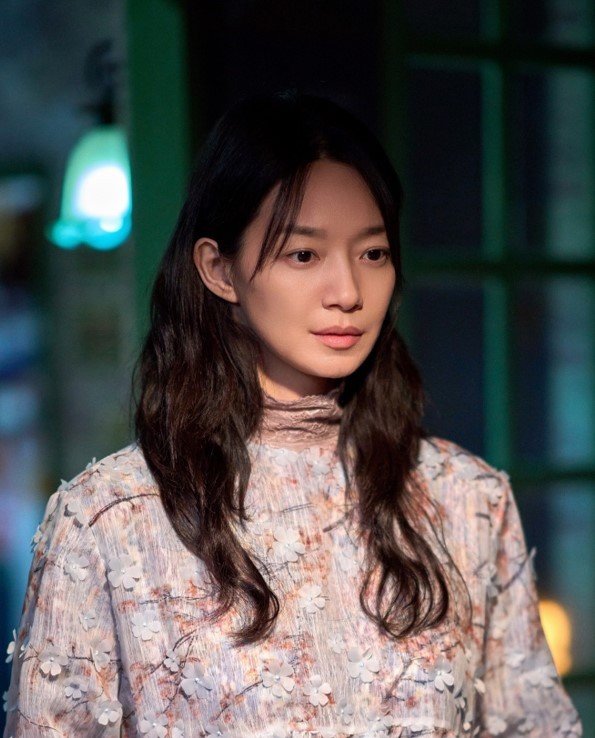
신민아, 시댁 사랑 듬뿍 받네…김우빈 가족 커피차 보냈다
2 weeks ago
57

로또 1등 당첨자 16명 17.9억씩 받는다…전국 명당 판매처 보니
4 weeks ago
56
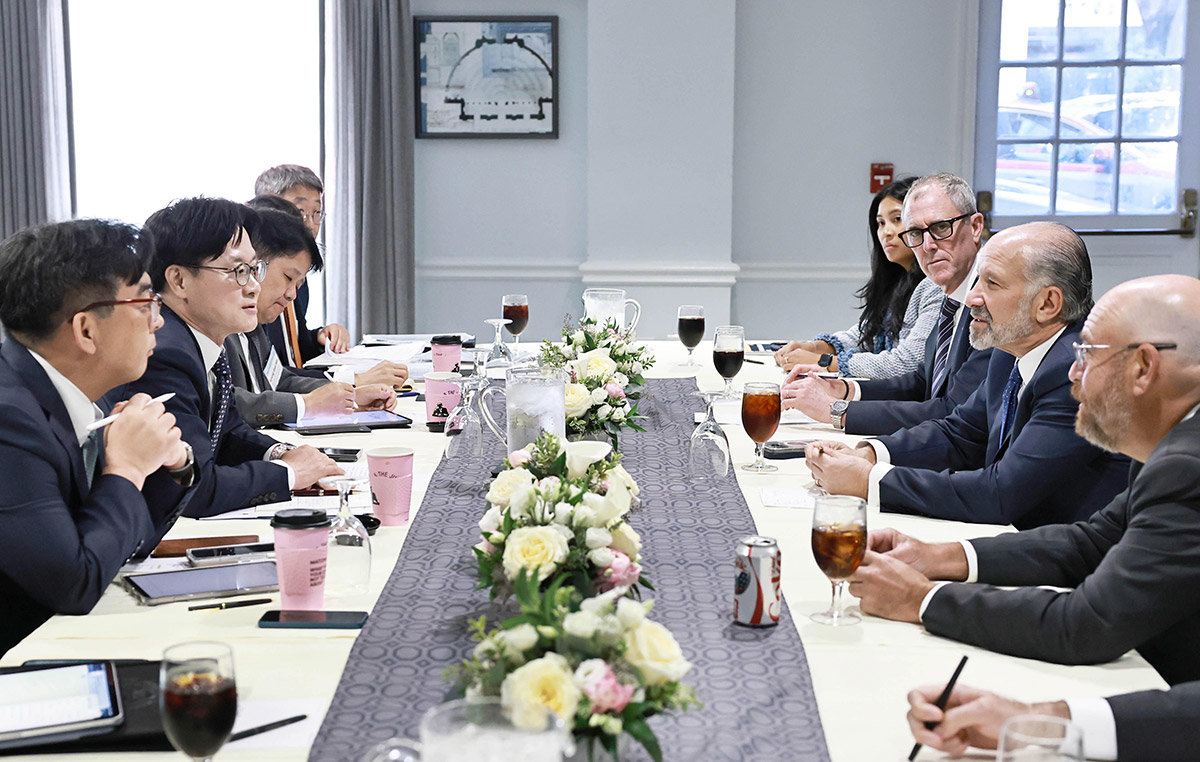
[사설]대미 투자 MOU 진통… 부실사업 선정은 양국 모두의 손해
2 weeks ago
52
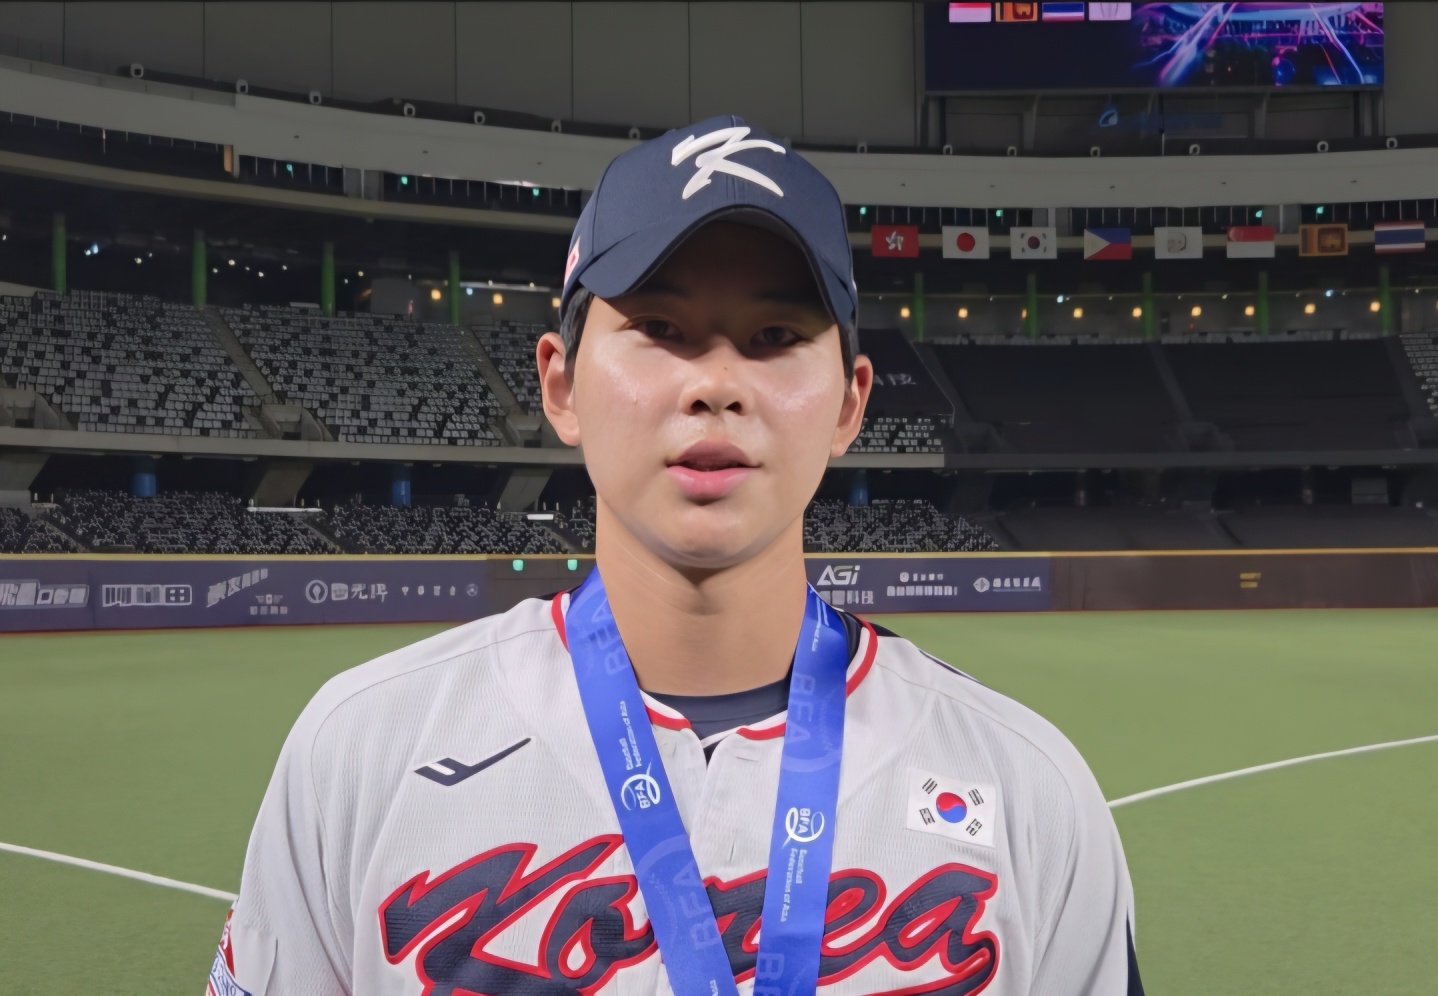
‘日 상대 완봉’ 차세대 국보급 투수 하현승, KBO 전체 1순위 정조준
2 weeks ago
51
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
