 1 day ago
6
노트북에서 실행한 Qwen 3.8 27B가 도구나 코드 실행 없이 신경망 가중치만 읽고, 해당 모델이 학습한 게임 중 Pac-Man, Pong, Breakout을 식별함 실험은 단순화한 게임을 강화학습한 정책 신경망의 부동소수점 가중치를 텍스트로 전달하고 게임을 맞히게 하는 방식이며, 게임별 프롬프트는 가중치를 제외하면 동일함 로컬 실행에는 17GB 모델을 사용했으며, 성공한 세 게임의 응답에 각각 약 46~65분이 걸림 네 번째 게임인 Freeway는 식별에 실패하고 Pac-Man과 비슷한 게임으로 판단해, 모든 사례에서 성공한 것은 아님 가중치 직접 해석과 코드를 이용한 가중치 수정은 구분해야 하며, 이번 결과만으로 소스 코드의 시대가 끝나거나 기계가 이해 불가능한 방식으로 스스로를 수정하는 미래를 단정하기는 어려움 Weight-Space Programming의 성과와 구분할 쟁점 Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights는 GPT-6 Astra 같은 최첨단 모델이 텍스트로 전달받은 신경망 가중치를 해석하고 수정하는 능력을 탐구함 연구진은 논문 형태로 작성했지만 이를 블로그 게시물로 분류함 LLM이 신경망의 각 부분이 무엇을 계산하는지, 또는 무엇을 계산해야 하는지 추론해 가중치를 분석하고 변경하는 작업을 Weight-Space Programming이라고 부름 연구 결과에 따르면 GPT-6 Astra는 원시 가중치만 보고 네트워크의 학습 과제를 알아내고, 환경 피드백 없이 작은 게임용 네트워크를 처음부터 작성할 수 있음 이렇게 작성한 네트워크가 PPO로 1억 스텝 학습한 네트워크보다 뛰어난 게임 성능을 보임 Qwen3.5-0.8B의 수학 능력 개선 실험에서는 경사값 없이 가중치의 0.016% 를 수정함 Qwen의 모델 카드에서도 경고하는 추론 반복 문제를 가중치에서 찾아 수정함 동일한 샘플링 설정에서 MATH-500 점수는 7.9%에서 48.1%로 상승했고, 별도 조정 없이 IFEval도 3배로 높아짐 Astra가 학습 루프를 작성하는 것은 허용하지 않음 다만 도구 없이 가중치를 읽는 능력과 코드를 사용해 다른 모델을 개선하는 능력은 별개의 질문임 spaCy 개발자 Matthew Honnibal은 두 능력을 혼동시킨다는 이유로 오해를 부르는 연구라고 비판함 Sean Goedecke의 ...
Related

Lemmings CSS 애니메이션
2 hours ago
2
AI와 개발한 1년 — 사라진 건 없고, 달라진 건 많다
2 hours ago
2
Show GN: getdeck - 슬라이드 레이아웃을 내 템플릿으로 저장하고 웹에서 고치는 서비스
4 hours ago
6
Show HN: 10년간의 리버스 엔지니어링 끝에 DOS Wing Commander 협동 플레이 구현
4 hours ago
6
Show GN: 아파트 인사이트 - 주변 시설·가격·도보·일조를 살펴보는 3D 지도
5 hours ago
6
당신의 암호학 음모론은 틀렸다
6 hours ago
3
내 ISP가 DNS를 가로채고 있었다
7 hours ago
3
worklog-system 주간보고 자동화 구축 경험기
7 hours ago
4
Popular

[ET특징주]펩트론, 일라이릴리 기술평가 종료 소식에 하락세
4 weeks ago
549

[美특징주]캠벨·제너럴밀스 등 강세…기술주 이탈해 소비재주로
2 weeks ago
544
[美특징주]레나, 버크셔해서웨이가 지분 매입 소식에 상승
4 weeks ago
401
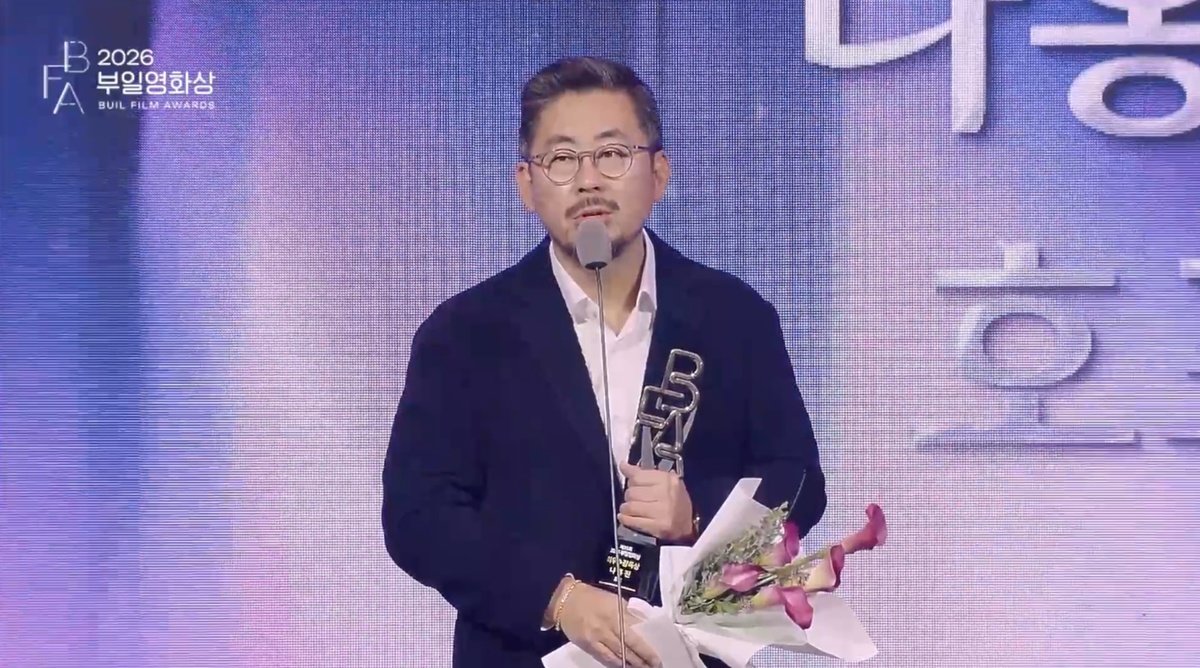
나홍진 감독 ‘호프’ 5관왕…최우수작품상=‘세계의 주인’ (종합)[2026 부일영화상]
4 weeks ago
380
[美특징주]휴렛패커드, AI 서버 신제품 공개에 주가 3%↑…신고가 경신
4 weeks ago
379
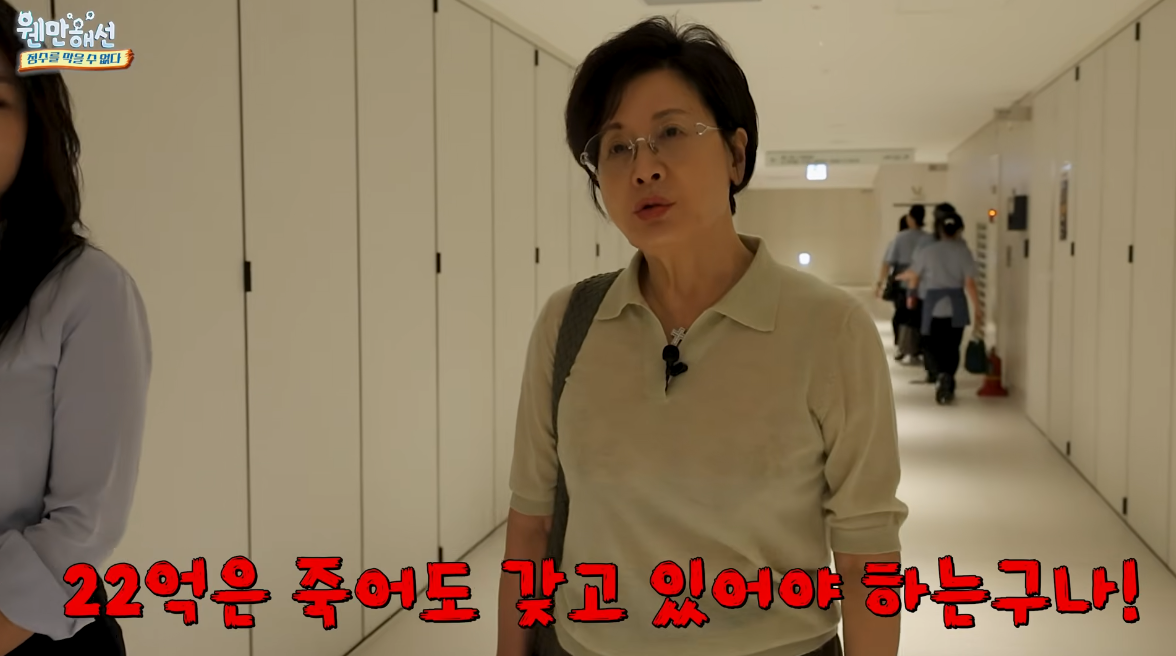
박정수, 230억 건물주다운 노후 플랜?…보증금 22억·월 500만원에 “마음에 들어”
4 weeks ago
379
[美특징주]마이크론, 메모리 호황 기대에도 4%↓…오픈AI 우려에 낙폭 확대
3 weeks ago
372
[美특징주]오픈AI관련株, 매출 기대치 하회에 동반 급락…코어위브 8%↓
3 weeks ago
370
[마켓톡스]금리 상승·AI주 선호에 밀린 소형주…매수 기회 올까-BTIG
3 weeks ago
368
한가인 “연정훈과 결혼 이틀 전 ‘못 하겠다’ 선언”…촬영장까지 찾아왔다
4 weeks ago
366
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
