 8 hours ago
5
Jevlike는 텍스트 문맥과 매번 달라질 수 있는 선택지 목록을 받아, 답을 단어별로 생성하지 않고 한 번의 처리로 선택지별 확률을 계산하는 소형 모델임 각 선택지를 쿼리 벡터로 만들어 문맥 토큰에 어텐션을 적용하고, 선택지별 문맥 벡터와의 점수를 계산한 뒤 softmax로 확률을 구함 기본 구성은 바이트 임베딩을 처음부터 학습하며, 선택적으로 가중치를 고정한 Hugging Face 사전학습 인코더에 작은 점수 계산 헤드만 학습할 수 있음 로컬 실험에서 합성 선택지 정확도는 약 98%, 목표 페이지를 분리한 Wikispeedia 다음 클릭 예측 정확도는 구성에 따라 26~29% 였으며, 빠른 시작 예제의 재현 결과는 아님 TypeSafe가 Jev 설계를 공개하지 않은 상태에서 만든 독립적인 연구용 출발점으로, Jev와 동등한 품질이나 비공개 학습 방식의 재현을 입증하지 않았음 목적과 처리 구조 Jevlike는 텍스트 하나와 N개의 텍스트 선택지를 입력받아 각 선택지의 확률을 반환함 Jev는 TypeSafe의 같은 유형 작업용 상용 모델이지만 설계는 공개되지 않았음 이 저장소는 Jev를 복제한 모델이 아니라, 입출력 형태가 같은 독립적인 초기 모델임 선택지 어텐션 헤드는 각 선택지를 텍스트를 나타내는 쿼리 벡터로 변환함 쿼리가 문맥 토큰에 어텐션 가중치를 부여해 선택지별 문맥 벡터를 만듦 공통 내적 연산으로 선택지와 문맥 벡터 쌍을 점수화하고, 선택지 전체에 softmax를 적용해 합이 1인 확률을 계산함 기본 인코더는 바이트 임베딩을 처음부터 학습함 선택적 Hugging Face 경로에서는 사전학습 인코더의 가중치를 고정하고 작은 점수 계산기만 학습함 데이터와 학습 및 평가 흐름 학습 데이터는 한 줄에 JSON 객체 하나를 담는 JSONL 형식이며, context, options, label 필드를 사용함 label은 정답 선택지의 0부터 시작하는 인덱스임 행마다 선택지 수가 달라도 되지만 최소 2개가 필요함 기본 작업 흐름은 합성 데이터 생성 → 학습 → 저장한 모델 평가 → 새 선택지 목록 예측 순서임 평가에서는 Top-1/Top-3 정확도와 기대 보정 오차를 계산함 Top-1은 가장 높은 점수의 선택지가 정답인 비율, Top-3는 상위 3개 안에 정답이 있는 비율임 기대 보정 오차는 예측 신뢰도와 관측 정확도를 비교함 선택지 목록에 잘못된 문맥을 연결하는 문맥 셔플 대조군도 출력하며, 유용한 모델은 이 ...
Related

존 그루버의 iPhone 18 Pro 리뷰
36 minutes ago
0
일본의 100세 이상 인구, 10만 명 넘어
36 minutes ago
0

사용자를 위해 일부러 어렵게 만드는 경험, 어디까지 괜찮을까?
38 minutes ago
0
섹스, AI, 그리고 종말
2 hours ago
0
macOS 27 Golden Gate 리뷰
2 hours ago
1
LLM에게 어디까지 맡길 것인가: AI 에이전트 기반 광고 분석 리포트 자동화
2 hours ago
0
스타트업을 피벗해야 할까? [동영상]
3 hours ago
1
SpaceXAI가 한 달 만에 Grok Bot을 만든 방법 [동영상]
3 hours ago
1
Popular
[美특징주]월마트, 동일매장 매출 성장 둔화에 주가 10% 급락
4 weeks ago
69
[속보] 네팔 홍수로 고립됐던 한국인 10명 중 9명 안전지역 이송
3 weeks ago
60
한로로, 코르티스 ‘조롱 가사’ 논란 직접 등판…“좋은 뜻으로 받아들여”
3 weeks ago
57
베테랑 김현수 끝내기안타…KT 선두 지켰다, 4년차 김정운은 데뷔 첫 승 감격 [SD 수원 스타]
3 weeks ago
56

“돌발적으로 저질렀다”…제자 물통에 소변 넣은 교사, 日 교육계 ‘발칵’
4 weeks ago
56
Qwen 3.8-Flash-Next(125B a6B), 2026년 8월 26일 공개 예정
3 weeks ago
54
부러진 히말라야 빙하가 물 가뒀다가 ‘펑’…“화산 폭발 같았다”
3 weeks ago
53

네팔 홍수 버티고 명소된 ‘기적의 초록집’…집주인이 밝힌 비밀은
2 weeks ago
52
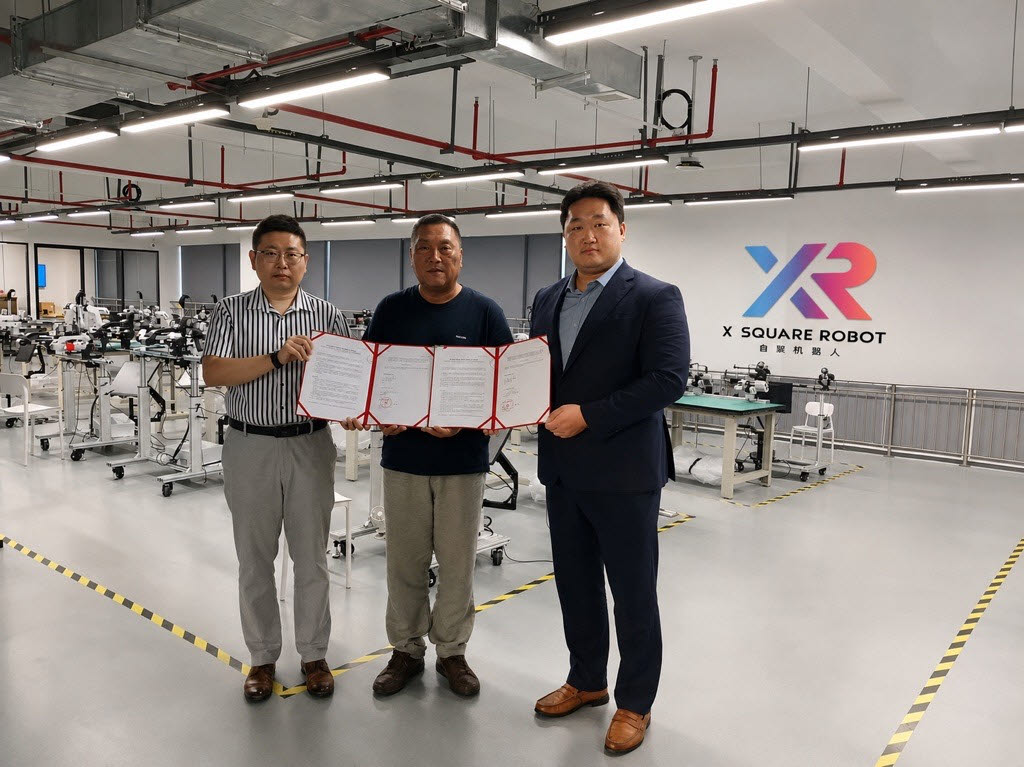
에브리봇, 中 피지컬 AI 기업 엑스스퀘어와 MOU…휴머노이드 사업 확대
3 weeks ago
51

'AI 의약 플랫폼' 미라보 바이오, 프리 A 40억원 투자 유치[마켓인]
4 weeks ago
48
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
