 1 week ago
7
55GB인 Qwen3.8 27B를 4비트 양자화로 17GB까지 줄여도, 과학 문제, 지시 준수와 에이전트 코딩 평가에서 원본과 눈에 띄는 성능 차이가 없었음 17GB 모델은 24GB RTX 4090에 약 64k 토큰 컨텍스트와 함께 올릴 수 있어, 소비자용 GPU에서도 원본에 가까운 작업 성능을 얻을 수 있음 약 10.7GB인 2비트 모델은 지시 준수 성능을 유지했지만 과학 문제와 코딩에서는 하락했으며, 같은 코딩 작업을 해결할 때 출력 토큰도 약 25% 더 사용함 1비트 모델은 과학 문제에서 무작위 추측 수준으로 떨어짐. 추론을 길게 허용하면 토큰 예산을 소진하고 빈 답을 반환하는 일이 늘어 오히려 점수가 낮아짐 양자화 품질은 원본과 토큰 예측이 얼마나 일치하는지보다 실제 작업을 얼마나 잘 해결하는지로 판단해야 하며, 로컬 실행에서는 모델뿐 아니라 필요한 컨텍스트까지 GPU 메모리에 들어가는지 확인해야 함 토큰 예측 차이보다 실제 작업 성능을 측정 앞선 Qwen3.6 27B 실험에서는 12GB에서도 SVG 펠리컨을 잘 생성했고, 16GB까지 지식 대부분을 유지함. 반면 커뮤니티에는 8비트조차 성능이 나빠진다는 불만과 로컬 LLM이 더 멍청하게 느껴지는 이유에 대한 논의가 있음 KL 발산이나 최상위 토큰 예측 일치율은 측정하기 쉽지만, 작업 해결 능력을 직접 알려주지는 않음 다른 토큰을 생성해도 같은 품질의 답을 바꿔 쓴 것일 수 있음 반대로 토큰 하나의 차이가 논리 오류를 만들거나 출력을 갑자기 끝낼 수도 있음 실제 성능은 과학 지식 평가 GPQA Diamond, 지시 준수 평가 IFBench, 에이전트 코딩 평가 Terminal-Bench 2.1으로 비교함 먼저 원본 BF16의 공식 결과를 재현한 뒤 양자화에 따른 변화를 확인함 실행 환경과 재현성 제약 Modal GPU에서 llama.cpp의 2026년 8월 16일 빌드를 사용했으며, 총비용은 약 3,000달러임 이전 빌드는 해당 모델을 지원하지 않음 원칙적으로 개인 노트북에서도 실행할 수 있지만, 이 벤치마크들은 펠리컨 생성 실험과 달리 시간이 많이 걸림 모델 양자화와 무관하게 F16 KV 캐시를 사용했으며, 32k 토큰당 약 2.3GB를 차지함 Unsloth 양자화는 2·4·8비트에 v2, 1비트에 v3를 사용함 2026년 8월 19일 v2 파일이 교체돼 대부분의 실험에 사용한 정확한 파일은 더 이상 제공되지 않음 추론 강도의 기본값은 xhigh 이며,...
Related

LLM과 함께 글 쓰는 법
3 hours ago
1
Show GN: 묻기 전에 먼저 움직이는 Slack AI 팀원
4 hours ago
1
Show GN: 채널톡, intercom 에 지친 팀들을 위해,, 레닛(lenit)을 소개합니다.
4 hours ago
1
Qwen 3.8 Omni Flash
5 hours ago
2

배달의민족 전자계약서 화면 개편기: AI에게 맡긴 것과 사람이 챙긴 것
6 hours ago
7
Show GN: SQLBraid - SQL을 그대로 쓰는 TypeScript 라이브러리
7 hours ago
4
OpenAI 해킹
7 hours ago
3
사진작가 오스틴 만의 iPhone 18 Pro 카메라 리뷰
8 hours ago
3
Popular
[美특징주]월마트, 동일매장 매출 성장 둔화에 주가 10% 급락
4 weeks ago
72
[속보] 네팔 홍수로 고립됐던 한국인 10명 중 9명 안전지역 이송
3 weeks ago
62

“돌발적으로 저질렀다”…제자 물통에 소변 넣은 교사, 日 교육계 ‘발칵’
4 weeks ago
59
한로로, 코르티스 ‘조롱 가사’ 논란 직접 등판…“좋은 뜻으로 받아들여”
3 weeks ago
58
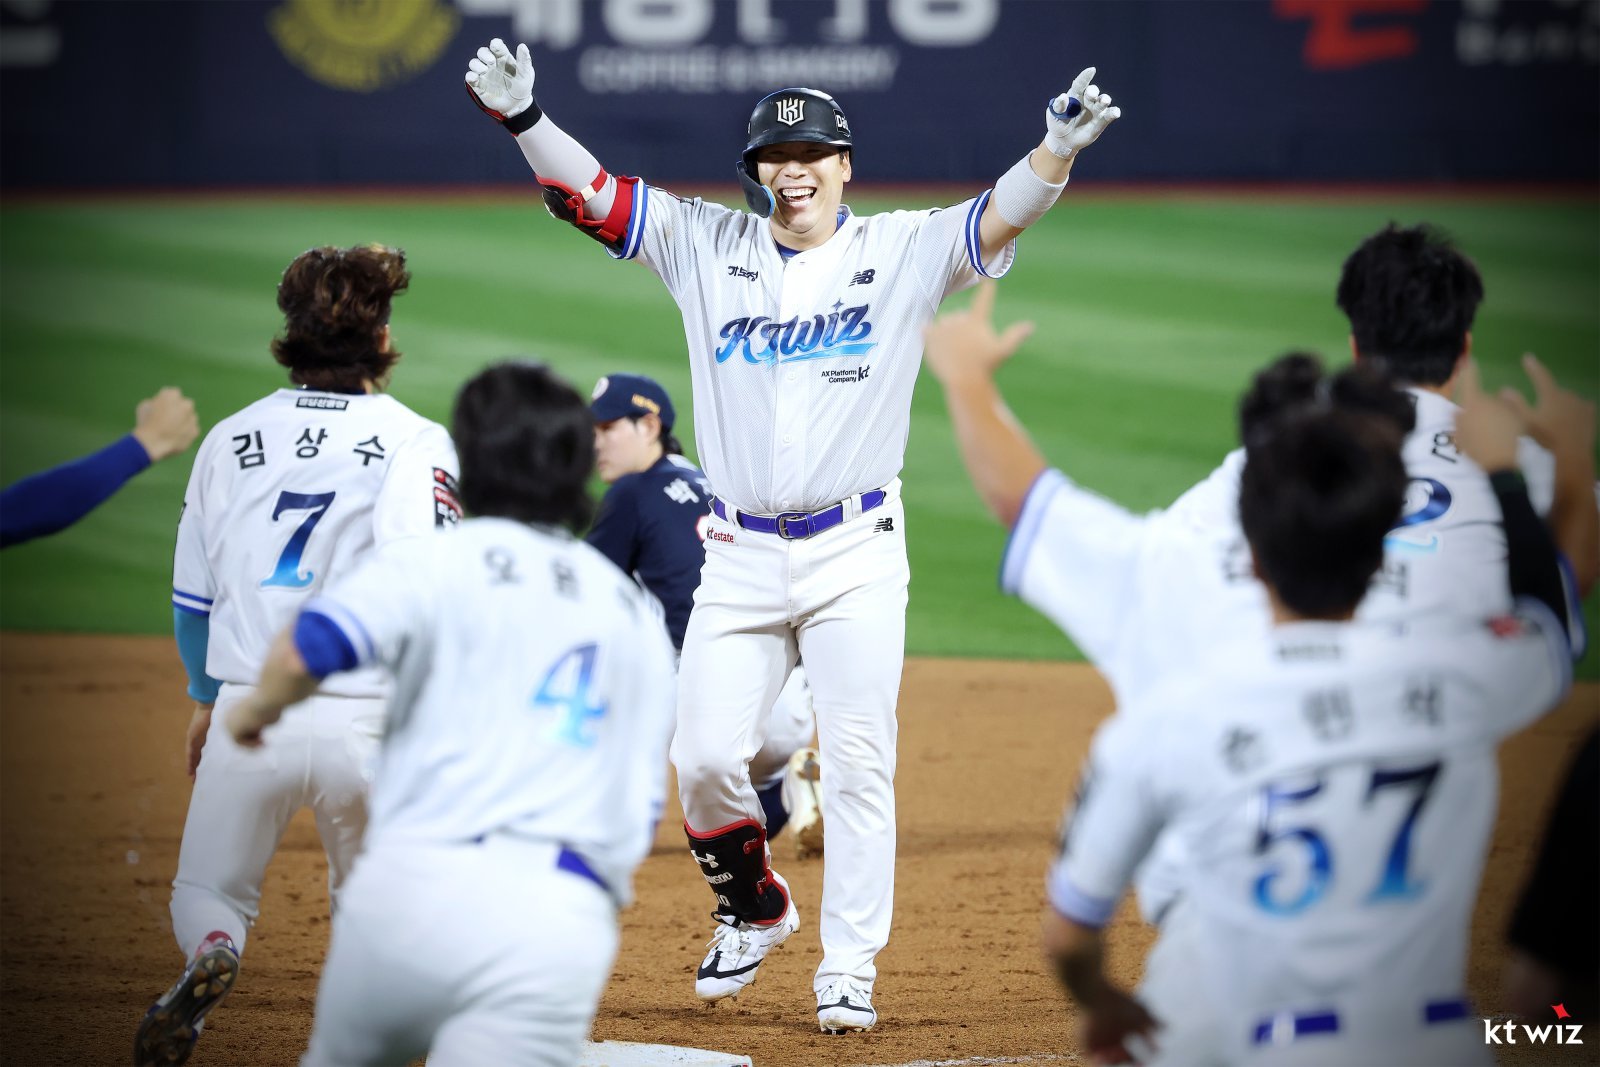
베테랑 김현수 끝내기안타…KT 선두 지켰다, 4년차 김정운은 데뷔 첫 승 감격 [SD 수원 스타]
3 weeks ago
57

네팔 홍수 버티고 명소된 ‘기적의 초록집’…집주인이 밝힌 비밀은
2 weeks ago
55
Qwen 3.8-Flash-Next(125B a6B), 2026년 8월 26일 공개 예정
3 weeks ago
54
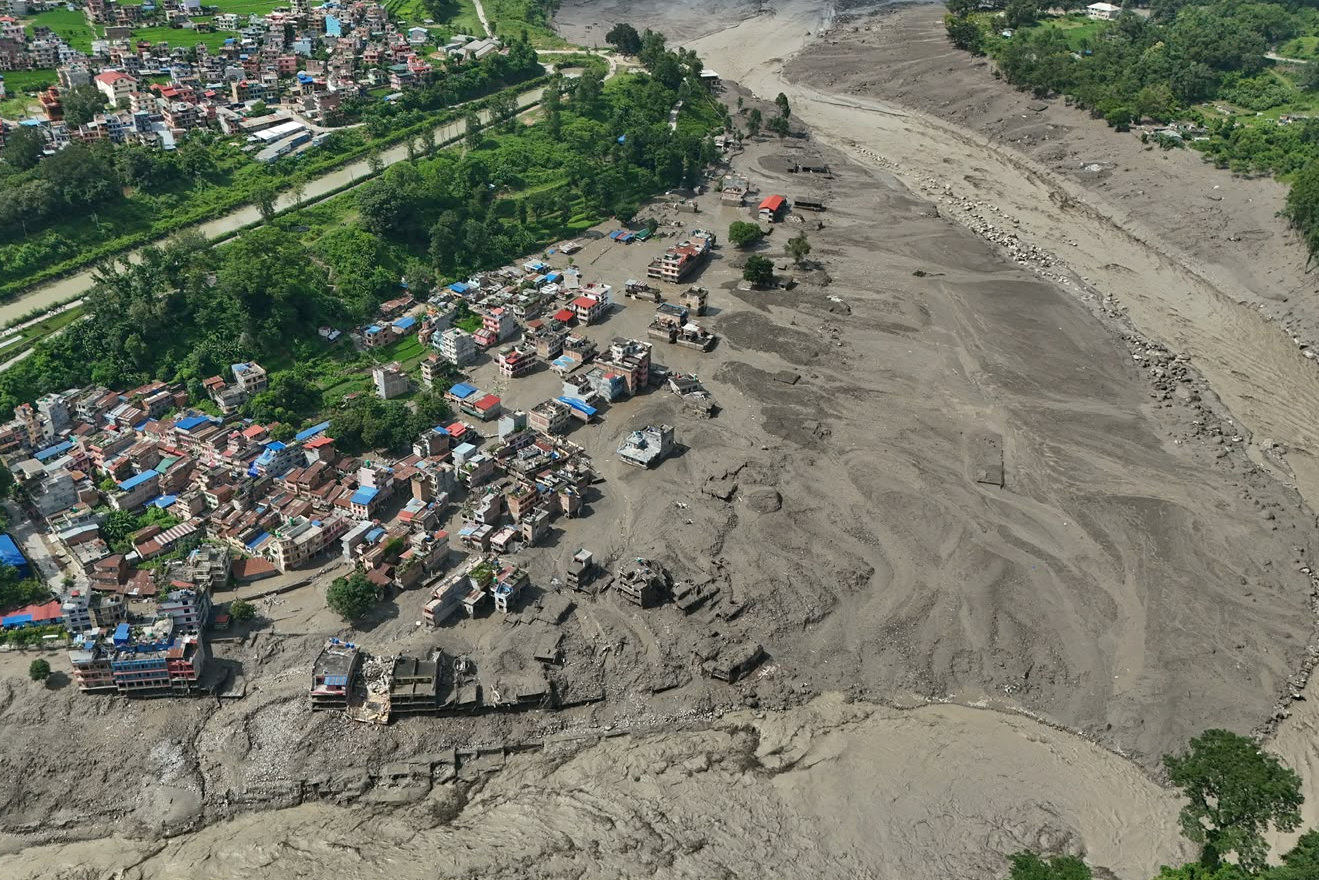
부러진 히말라야 빙하가 물 가뒀다가 ‘펑’…“화산 폭발 같았다”
3 weeks ago
53
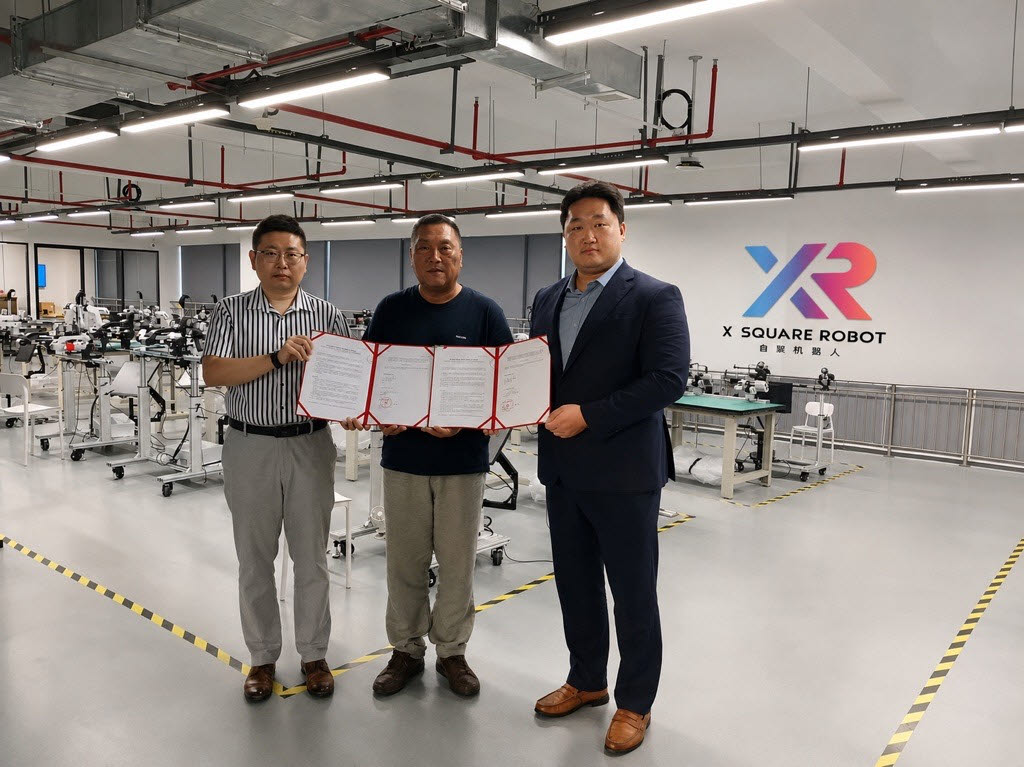
에브리봇, 中 피지컬 AI 기업 엑스스퀘어와 MOU…휴머노이드 사업 확대
3 weeks ago
51

'AI 의약 플랫폼' 미라보 바이오, 프리 A 40억원 투자 유치[마켓인]
4 weeks ago
51
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
