 2 hours ago
2
Contrastive Language Models(CLM) 는 상태와 행동을 대조 학습으로 연결하는 시스템 1 모델로, 현재 상태와 후보 행동의 임베딩을 비교해 가장 높은 점수의 행동을 선택함 공개한 CLM-8B는 컴퓨터 사용, 게임, 도구 호출 과제에서 Jev와 비슷한 성능을 내면서 지연 시간을 최대 9배 줄임 상태와 행동 인코더를 분리해 임베딩을 독립적으로 캐싱하며, 행동 집합이 고정된 환경에서는 매 단계 상태 임베딩만 다시 계산함 가벼운 미세조정을 거친 CLM-8B는 DeepSWE 81.6%, Terminal Bench 2.1 87.6% 로 최고 성능을 기록하고, Jev보다 4~6배 빠르게 추론함 테스트 대조 손실은 연산량, 데이터 규모, 모델 크기에 따라 멱법칙으로 감소하며, 어려운 오답을 처음부터 학습하기보다 사전학습 이후 정교화에 활용할 때 더 높은 정확도를 얻음 상태와 행동을 연결하는 대조 학습 CLM은 빠르고 일반화 가능한 의사결정을 위한 시스템 1 모델로, 상태 인코더와 행동 인코더를 대규모 데이터에서 함께 학습함 InfoNCE 목적 함수는 각 상태를 정답 행동에 가깝게, 다른 행동들과는 멀어지게 만듦 두 인코더는 입력을 공통 임베딩 공간으로 매핑하며, 상태와 행동의 점수는 임베딩 간 코사인 유사도로 계산함 배포 시 현재 상태와 후보 행동 집합을 받아 가장 높은 점수의 행동을 선택하는 제로샷 행동 분류기로 사용함 학습에는 양방향 InfoNCE를 사용함 일치하는 상태와 행동 쌍 B개로 B×B 유사도 행렬을 구성하고, 상태에서 행동을 찾는 방향과 행동에서 상태를 찾는 방향을 모두 최적화함 중간학습에서는 의미상 비슷하지만 틀린 행동인 어려운 오답 예제(hard negatives)를 추가해, 정답 행동과 그럴듯한 오답을 구별하도록 학습함 인코더 구조와 캐싱 효율 각 인코더는 동결된 LLM 백본과 학습 가능한 MLP 투영 헤드로 구성됨 마지막 토큰의 은닉 상태를 정규화한 뒤 투영 헤드에 전달함 2,000만 매개변수의 투영 헤드만 학습하며, LLM에는 기울기를 전달하지 않음 LLM 임베딩을 한 번 미리 계산한 뒤 여러 실험 설정에서 재사용하므로 스케일링 실험 비용을 줄일 수 있음 Nemotron DQA 데이터셋의 전체 사전학습 실행은 RTX 4090 GPU 한 장에서 약 1시간 걸림 상태와 행동을 분리하면 임베딩을 각각 캐싱하고 재사용할 수 있음 Super Mario처럼 상태는 계속 변하지만 행동 집합은 ...
Related

Rails World 2026 개막 기조연설 [영상]
29 minutes ago
0
예산별 최고의 LLM, 매일 업데이트
1 hour ago
0
Show HN: Times New Bastard 같은 괴상한 폰트 만들기
1 hour ago
0
폴란드 Starlink 지상국에서 화재, 방화 공격 의심
2 hours ago
1
GitHub, 3주가 지나도록 악성 모방 소프트웨어를 삭제하지 않음
2 hours ago
3
영국군, 자국 방어 위해 다른 나라 위성 전파 방해 중이라고 BBC에 밝혀
3 hours ago
3
Windows 스크롤 바 단축 조작의 간략한 역사
3 hours ago
1
모든 샌드위치를 즐기세요
3 hours ago
1
Popular
[속보] 네팔 홍수로 고립됐던 한국인 10명 중 9명 안전지역 이송
4 weeks ago
76
Qwen 3.8-Flash-Next(125B a6B), 2026년 8월 26일 공개 예정
4 weeks ago
76
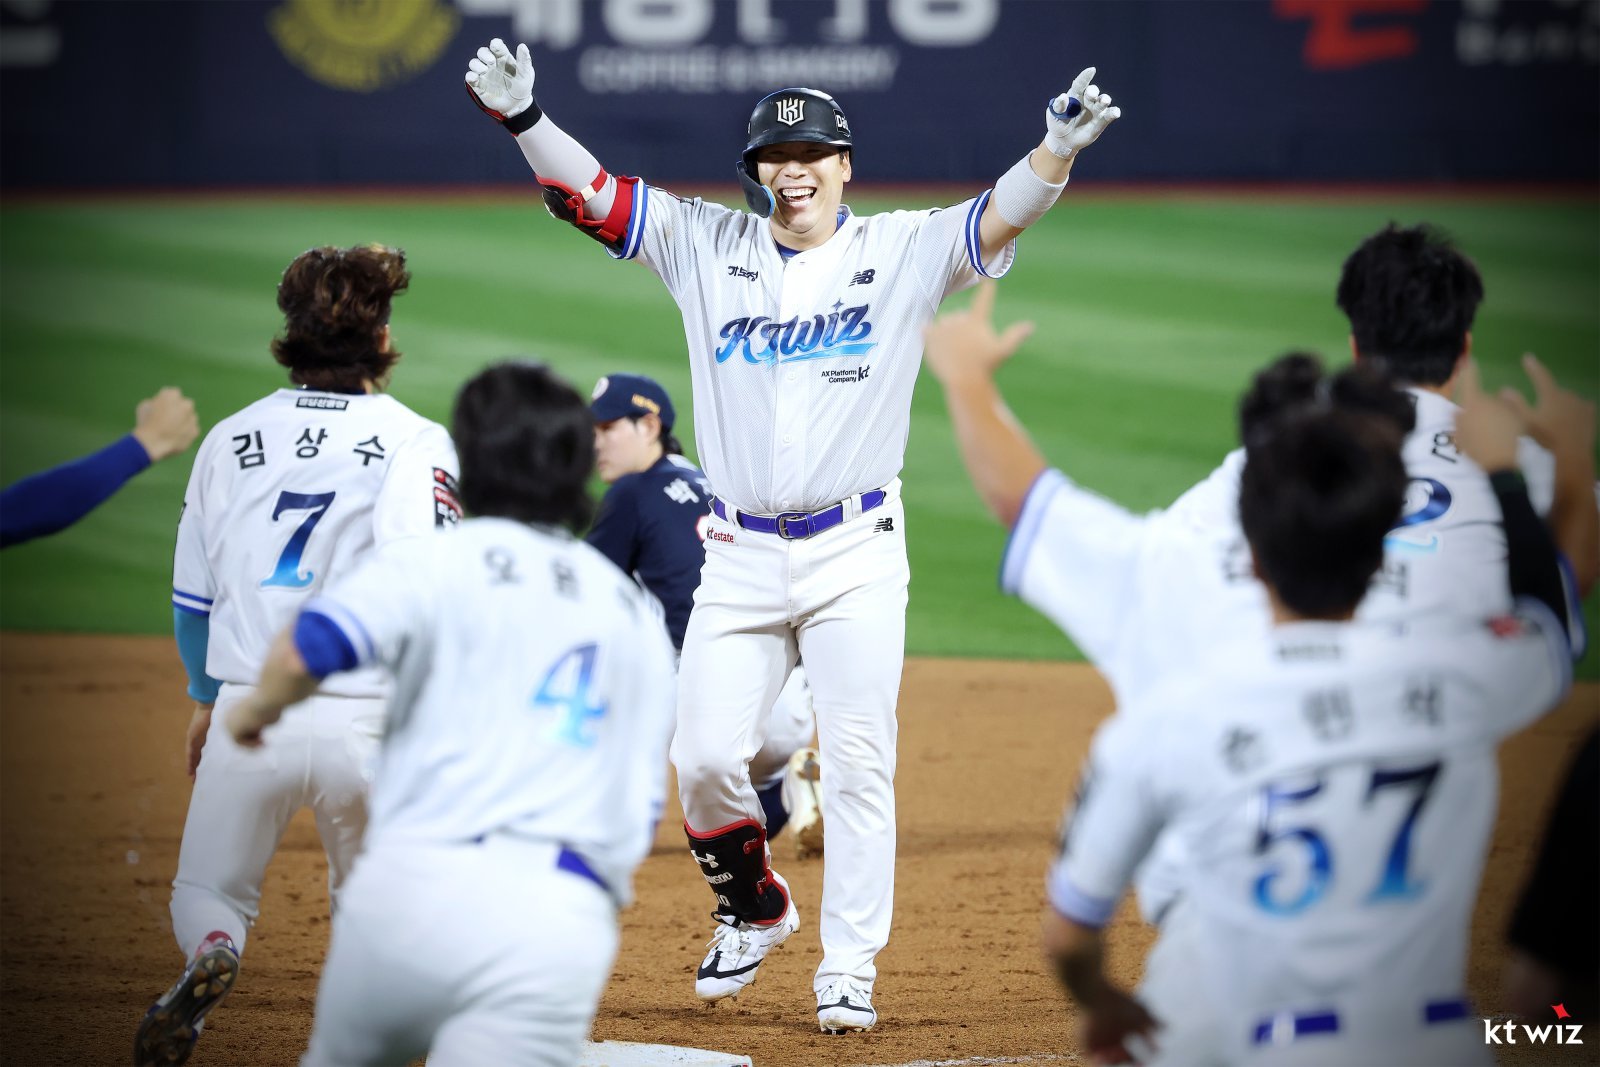
베테랑 김현수 끝내기안타…KT 선두 지켰다, 4년차 김정운은 데뷔 첫 승 감격 [SD 수원 스타]
4 weeks ago
72

네팔 홍수 버티고 명소된 ‘기적의 초록집’…집주인이 밝힌 비밀은
3 weeks ago
71

부러진 히말라야 빙하가 물 가뒀다가 ‘펑’…“화산 폭발 같았다”
4 weeks ago
67

‘실종 허위종결’ 파문에 고개 숙인 제주경찰청장…“모든 실종사건 재조사”
4 weeks ago
63

제니, 드레스 입고 와이어 촬영도…아찔+강렬한 비하인드
3 weeks ago
54

“복구 끝나기도 전에 또 비”…거제·통영 호우 피해지역 ‘긴장’
4 weeks ago
53

실종아동·입양인 개인정보 117만건 ‘싹’ 털렸다…유출 신고도 늦어
4 weeks ago
53
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
