 8 hours ago
5
UNIST, 속내 읽는 AI 학습법 ‘마르보’ 개발 UNIST 연구팀이 상대 AI의 정체를 추리하도록 훈련하는 학습법 ‘마르보’를 개발했다. 마피아 게임 승률이 기존보다 24%포인트 높았다. 챗GPT 생성 이미지 인공지능(AI)끼리 ‘마피아 게임’을 하면 어떤 AI가 이길까.국내 연구진이 다른 AI의 말을 그대로 믿지 않고 행동까지 따져 숨은 정체를 추리하도록 훈련하는 기술 ‘마르보(MARBO)’를 개발했다. 이 기술로 훈련한 AI는 마피아 게임에서 기존 방식으로 훈련한 AI보다 평균 승률이 24%포인트 높았다.1일 울산과학기술원(UNIST)은 인공지능대학원 한승열 교수팀이 AI 학습 기술 마르보(Multi-Agent Relational Belief Optimization)를 만들었다고 밝혔다.마르보는 대형언어모델(LLM) 기반 AI가 상대의 역할과 의도를 추론하고 그 판단에 맞춰 말하고 행동하도록 가르치는 학습법이다.여러 AI가 정보를 주고받으며 협력하거나 경쟁하는 환경에서 AI는 상대의 역할이나 의도를 직접 알 수 없다. 소통이 원활하지 않아 정보가 부족하거나 상대가 일부러 속이는 경우도 생긴다. 이때 잘못된 정보를 그대로 받아들이면 AI는 판단을 그르치기 쉽다.그동안 연구자들은 주로 비슷한 상황에서 사람이 보인 행동 패턴을 AI가 따라 하도록 하는 데 집중했다.반면 연구팀은 상대에 대한 추론을 먼저 가르치고, 그 결과를 말과 행동 학습에 활용하는 방식을 택했다.마르보의 핵심은 ‘관계적 믿음(Relational Belief)’이다. AI가 상대의 정체와 관계를 두고 스스로 내린 추정을 뜻한다. 상대가 협력할 대상인지 경계할 대상인지 가늠하는 판단으로, 새 정보가 들어오면 바뀔 수 있다.● 상대 정체 추리부터 발언 전략까지 ‘3단계 학습’ ‘마르보’의 3단계 학습 과정이 담긴 그래픽. 울산과학기술원 제공 학습은 △정체 추리 △행동 학습 △발언 학습의 세 단계로 이뤄진다. 첫 단계에서 AI는 대화와 행동을 바탕으로 상대가 어떤 역할이며 누구와 같은 편인지 추리하는 법을 익힌다. 연구팀은 함께 참여하는 AI 조합을 무작위로 바꿔 AI가 다양한 상황을 겪도록 했다.두 번째 단계는 추리와 행동을 일치시키는 과정이다. AI가 상대의 정체를 정확히 판단하고 목표에 유리한 행동을 고를 때만 좋은 점수를 주는 방식이다. 기존 학습법은 추리가 틀렸어도 결과가 우연히 유리하면 좋은 평가를 줬다. 마르보는 이런 경우를 걸러낸다....
Related
[헬스케어픽] 인수부터 협력까지···오픈AI·오라클·삼성, 서로 다른 전략
1 hour ago
2
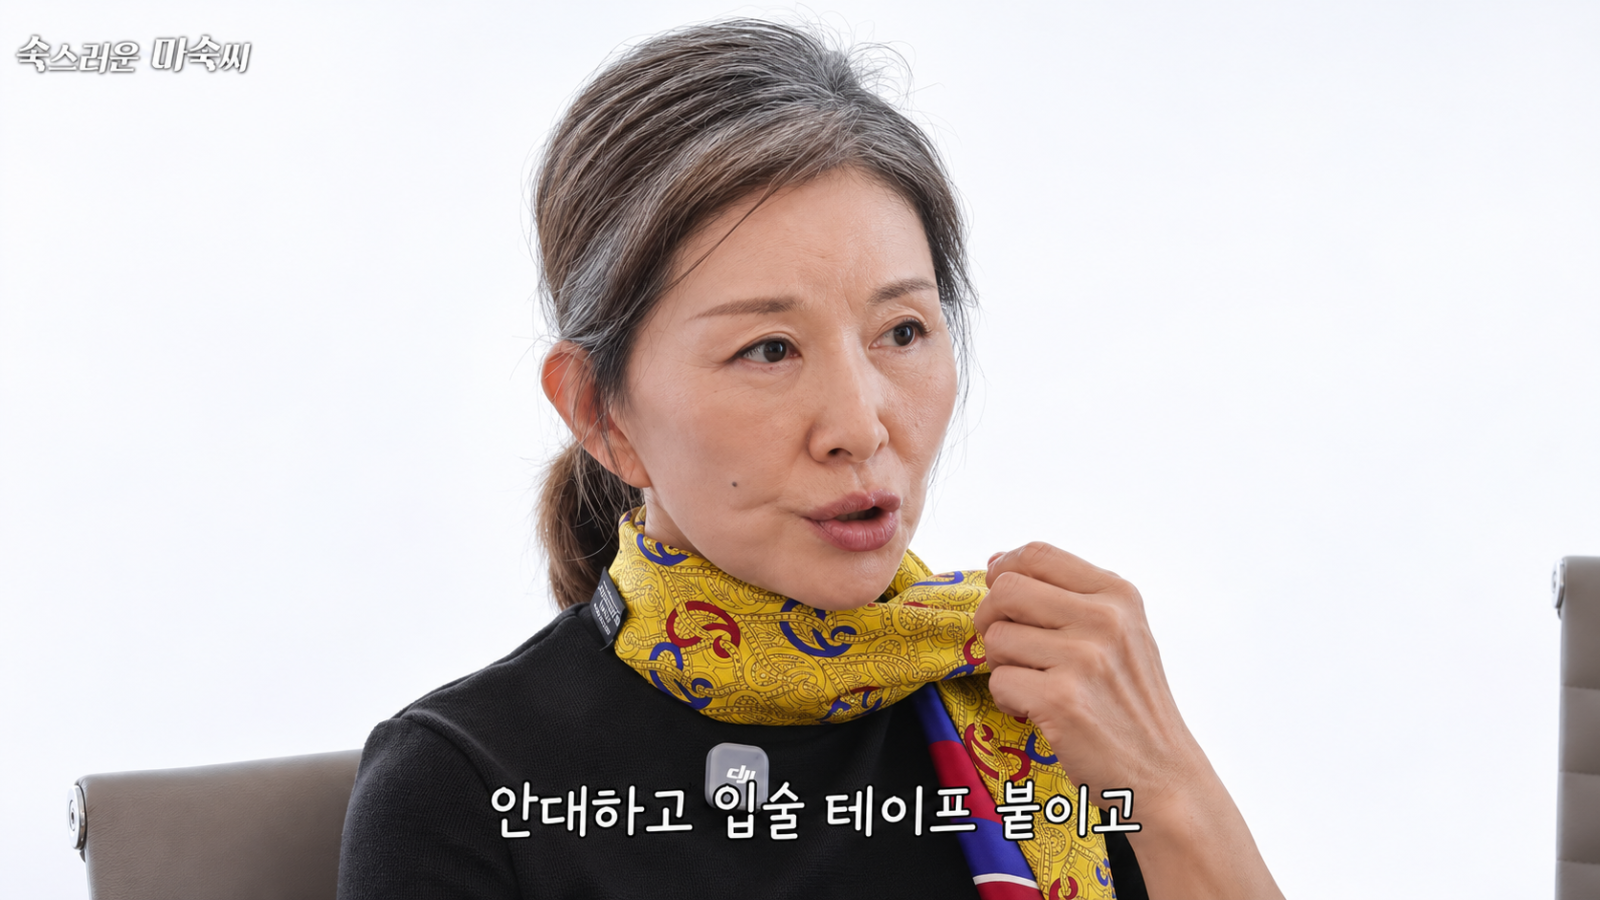
66세 이미숙 “잘 때 입술에 테이프 붙인다”…숙면에 정말 도움 될까? [건강팩트체크]
2 hours ago
2
허각 “갑상샘암 수술 후 음이탈, 인생 끝난 줄”…고음 안 나온 이유는 [건강팩트체크]
2 hours ago
0
[강원창업주간] 하몽하몽 “억대 연수익 내려놓고 택한 키즈풀빌라 경영, AI로 고도화중”
3 hours ago
6
KAIST, AI 전문 지식 학습시간 최대 70% 단축 기술 개발
3 hours ago
3
AI를 만난 예술가, 새 길을 찾다…퐁피두센터 한화
3 hours ago
3
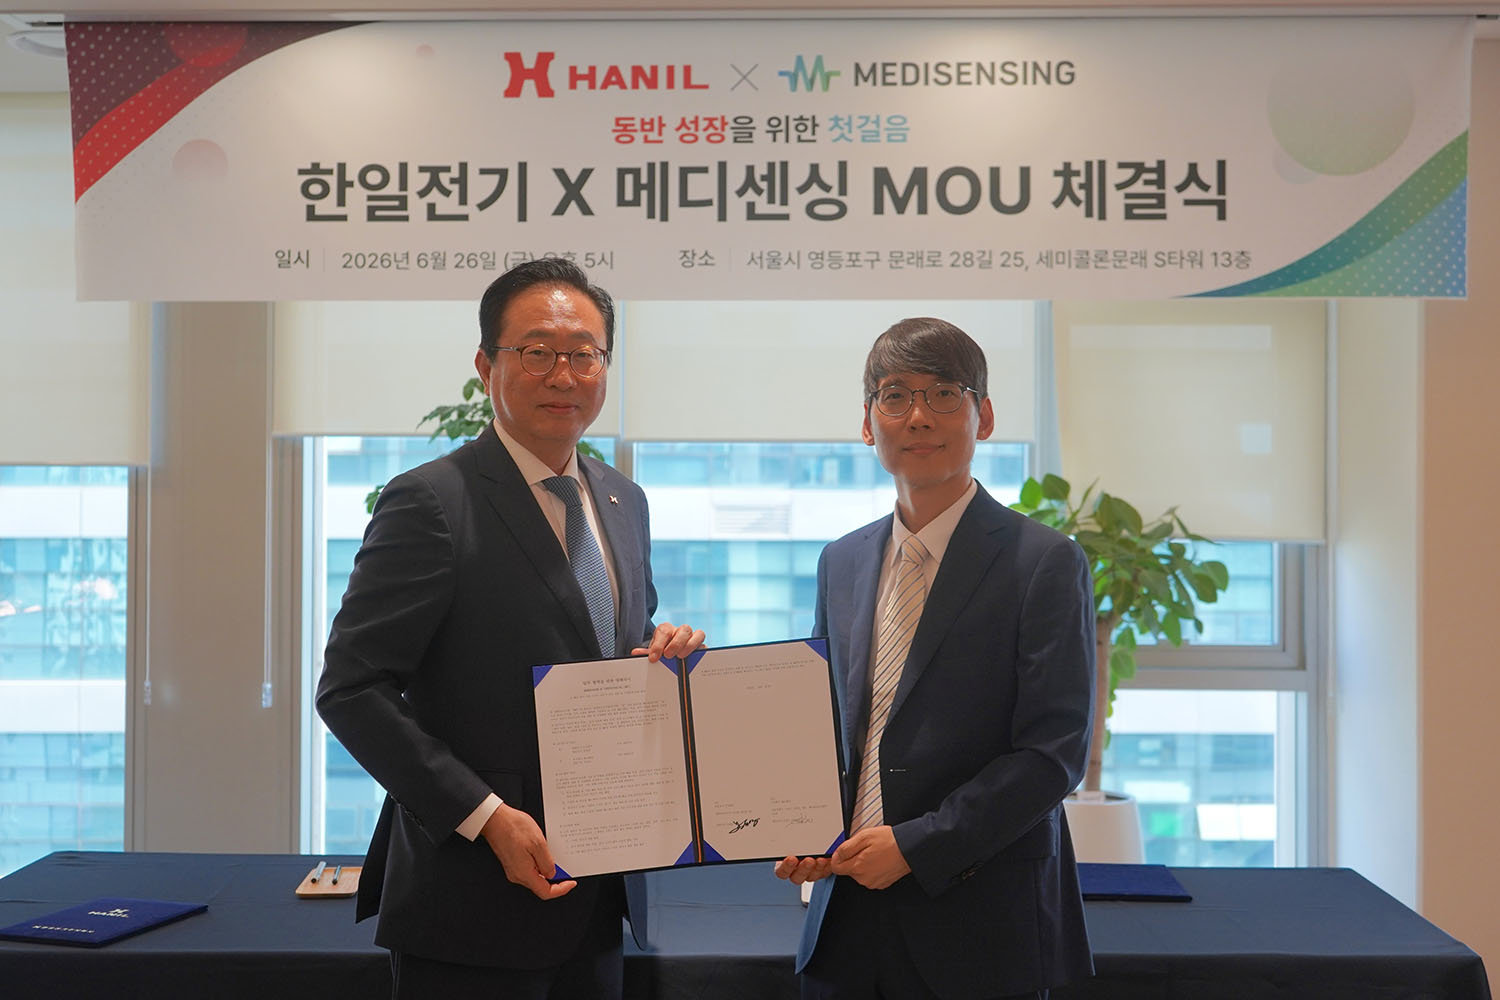
서울과기대 기술지주 자회사 메디센싱 “한일전기와 폐음 분석 AI 기반 스마트 청진기 개발 나선다”
4 hours ago
3
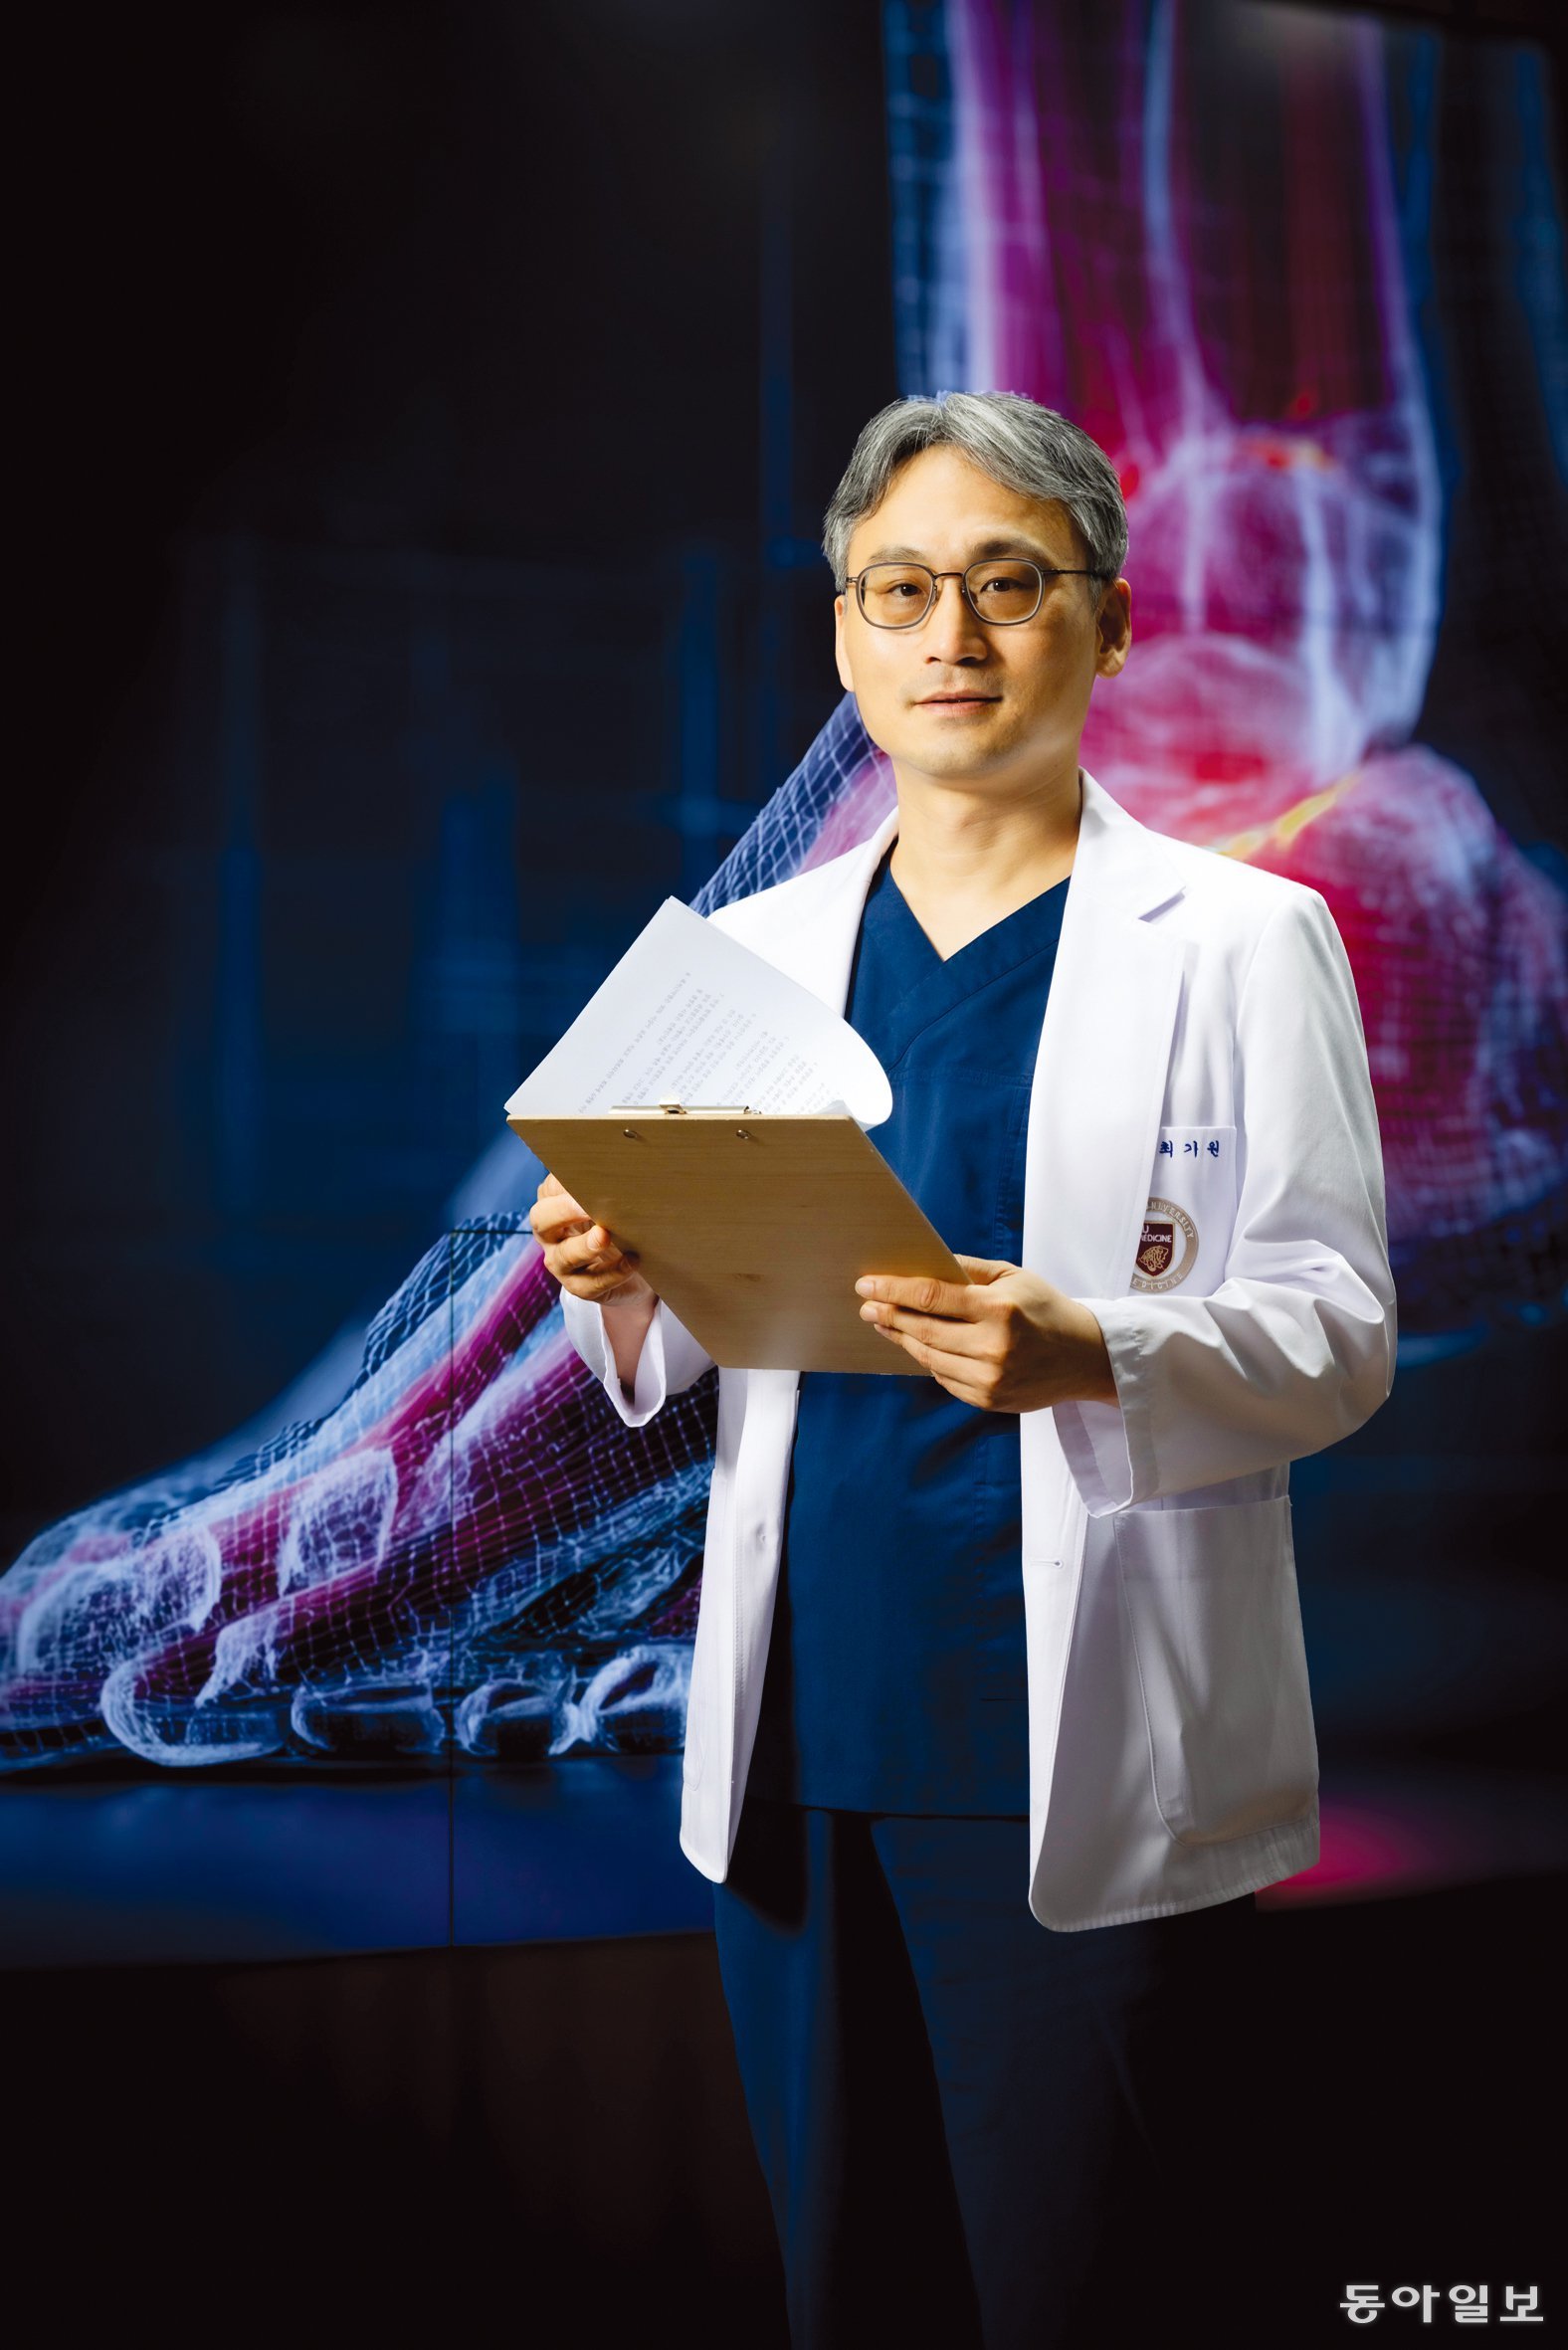
“발과 발목 통증, 최신 첨단 치료로 상황별 맞춤 해결!”[건강 기상청 : 증상으로 본 질병-족부질환]
15 hours ago
6
Popular

주말 새 2금융권까지 해킹피해 확산에…당국, 4일 전 금융업권 협회장·금융사 대표 긴급 소집
4 weeks ago
497

임산부석 차지한 노인…다리 깁스한 34주 만삭 임산부는 결국
4 weeks ago
483

승부 가리기엔 11회가 모자랐다…KT, 연장 접전 끝 롯데와 2-2 무승부→매직넘버 2
4 weeks ago
482

“군대 안가” 자랑한 축구대표팀에…안철수 “군대가 혐오시설? 군면제 없애야”
4 weeks ago
474

은행권 AI 연쇄해킹…공격서버에 ‘중국어 문자열’ 있었다는데
4 weeks ago
468

[ET특징주]펩트론, 일라이릴리 기술평가 종료 소식에 하락세
3 weeks ago
462

[美특징주]캠벨·제너럴밀스 등 강세…기술주 이탈해 소비재주로
2 weeks ago
460
이효리, 잔고 10만원·찬물 샤워 '쉬었음 청년' 커플 사연에.."너무 마음 아파"[연애전쟁]
4 weeks ago
373
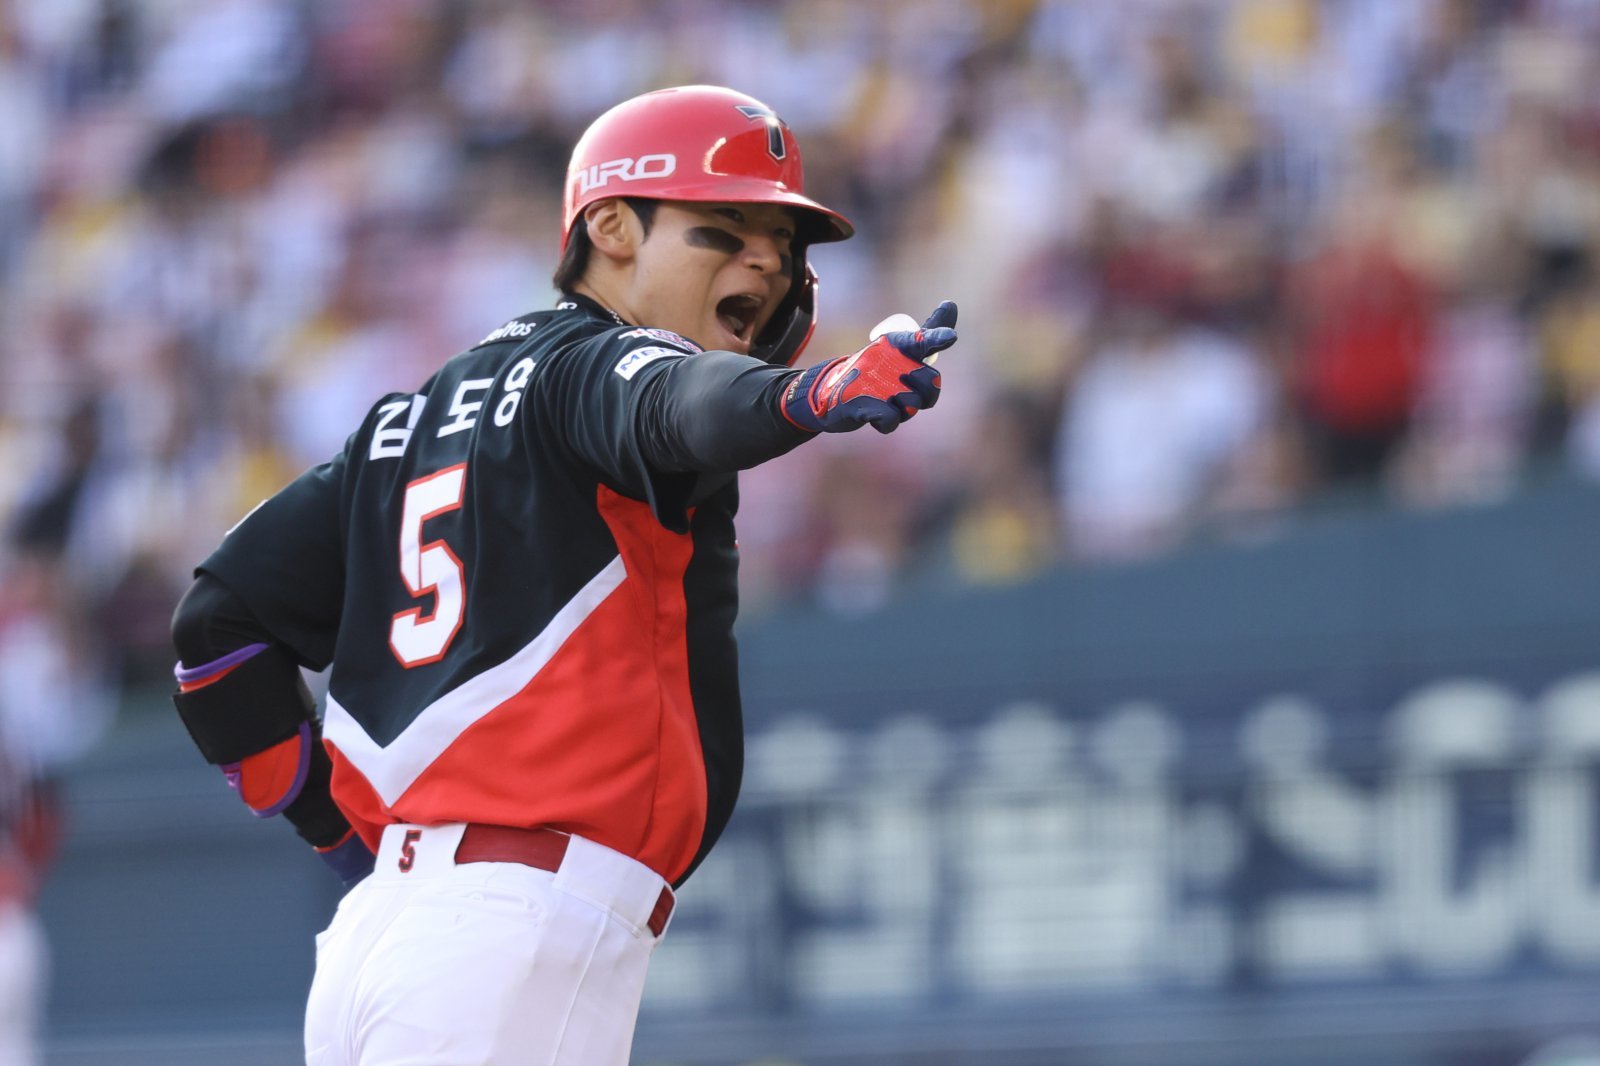
“왜 슈퍼스타인지 증명했다” 김도영, 9회초 역전 스리런포 작렬…KIA 3위 자리 지켰다
4 weeks ago
370
존슨앤존슨, 켄뷰 분사로 혁신 의약품 집중…목표가 상향-씨티
3 weeks ago
357
 English (US) ·
© Clint's Theme Park 2026. All rights are reserved
